Open GGOOAI 开源项目

MonkeyOCRv2
模型视觉
项目解读
README 精简 · 2 个月前更新这个项目是什么?
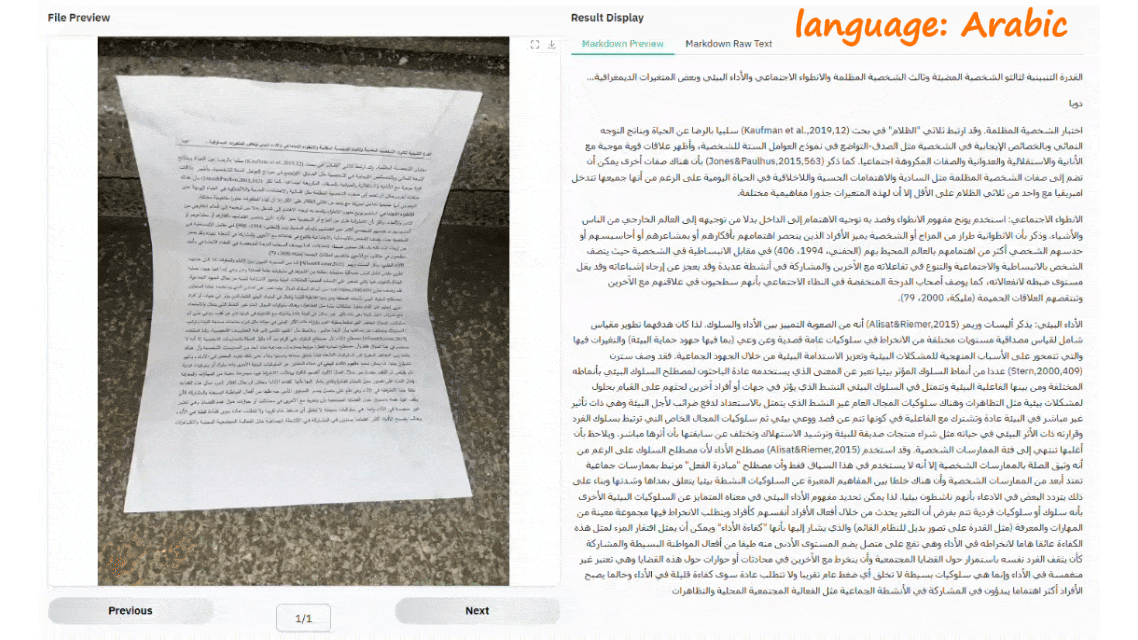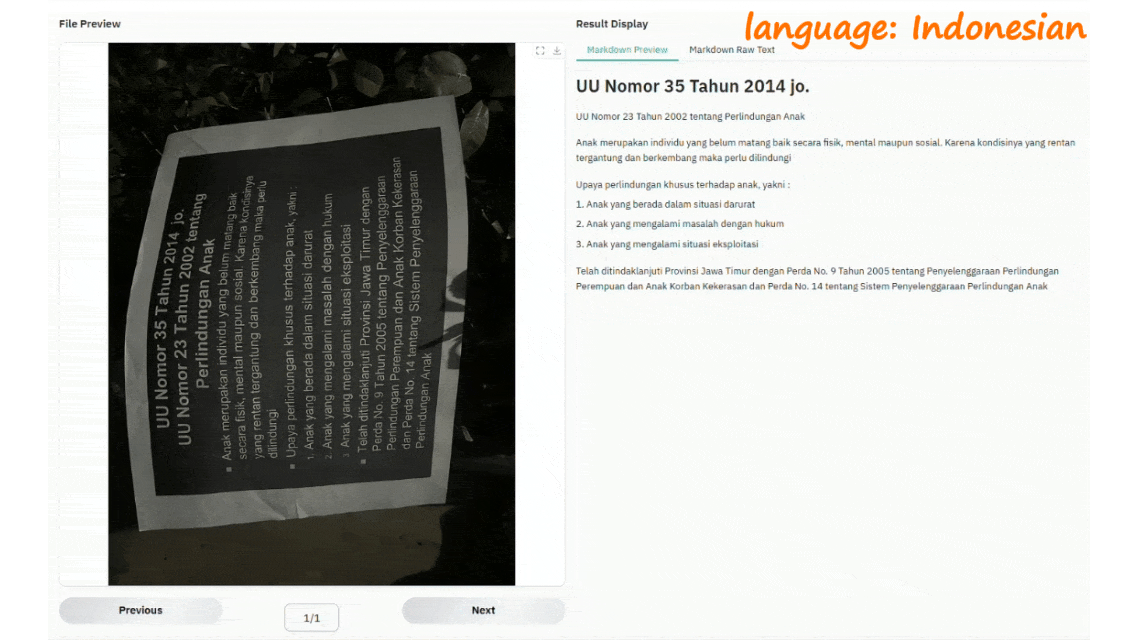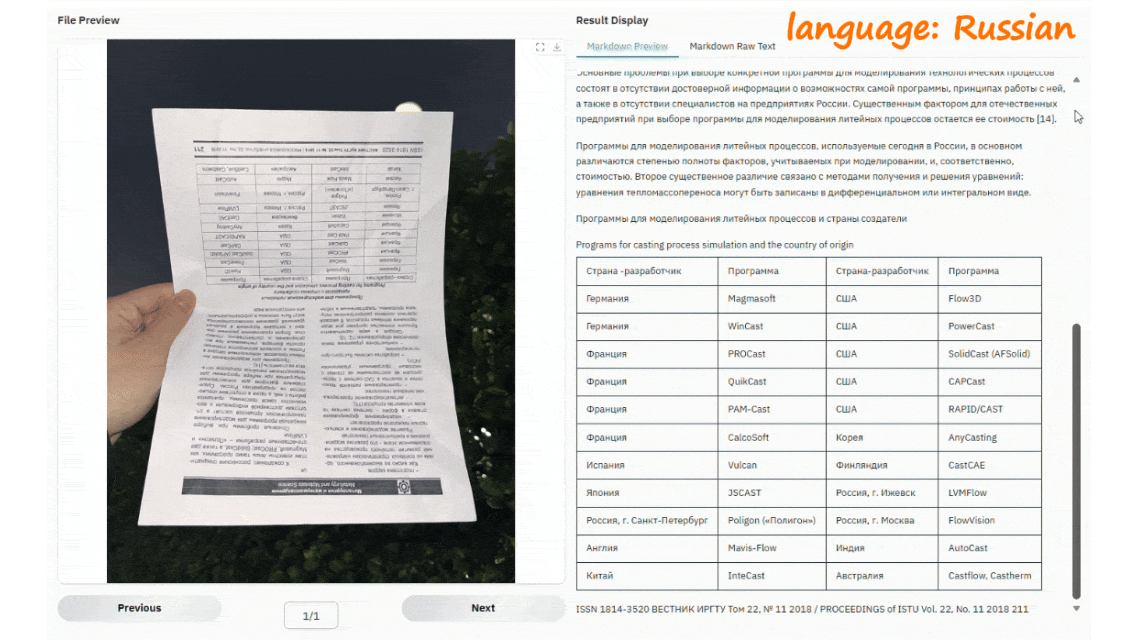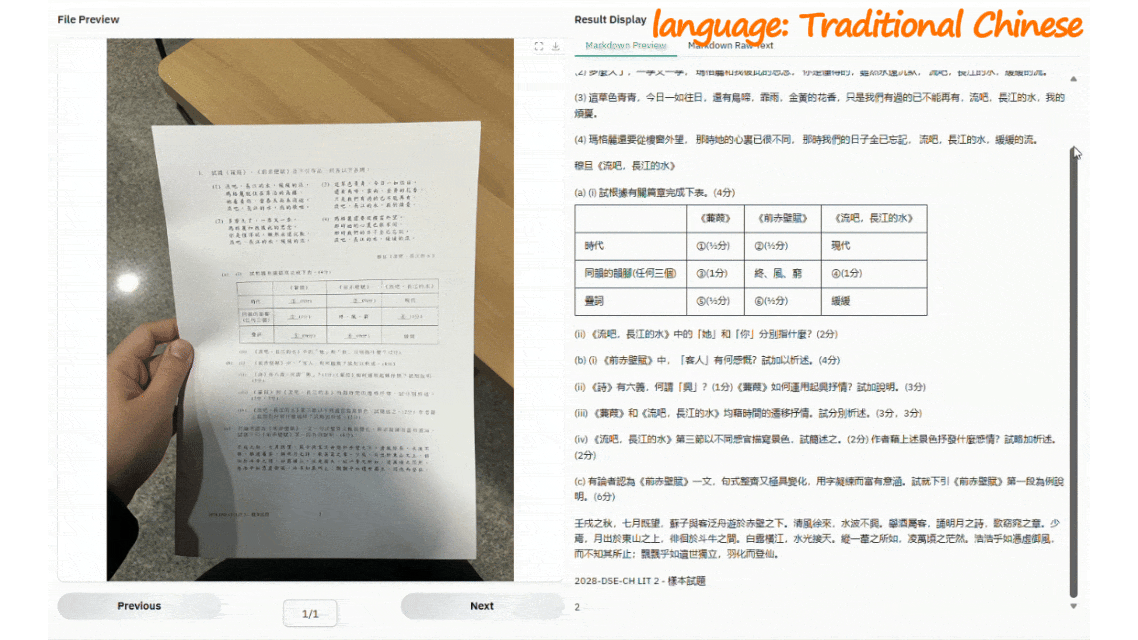
面向文档 AI 的视觉-文本基础模型,统一解决文档解析、理解、文本识别、公式识别、篡改检测与重叠文本分割等任务,适用于科学论文、历史文档、医疗报告等多语言文本密集型场景,并可作为视觉编码器集成到各类 OCR 系统中。
解决了什么问题?
公开资料暂未说明。
可以用来做什么?
公开资料暂未说明。
正在读取最新信息…
正在读取评论…
Open GGOOAI 开源项目面向文档 AI 的视觉-文本基础模型,统一解决文档解析、理解、文本识别、公式识别、篡改检测与重叠文本分割等任务,适用于科学论文、历史文档、医疗报告等多语言文本密集型场景,并可作为视觉编码器集成到各类 OCR 系统中。
公开资料暂未说明。
公开资料暂未说明。
来自公开新闻、社区讨论、RSS 与 X 的相关信息。
暂时还没有采集到相关动态。
按时间倒序,每位访客 5 分钟可发送一次。
还没有评论。